
Enterprise Search
Richtlinien, Handbücher, Tickets, Verträge und technische Dokumentation semantisch erschließen.
AOIT AI Solutions · Antworten mit Quellenbezug
Retrieval-Augmented Generation verbindet Sprachmodelle mit freigegebenen internen Wissensquellen. Wir strukturieren Dokumente, Berechtigungen, Metadaten und Aktualisierungsprozesse so, dass Antworten auf relevanten Unternehmensinformationen beruhen und Quellen sichtbar bleiben. Zugriffsschutz wird bereits beim Abruf durchgesetzt.
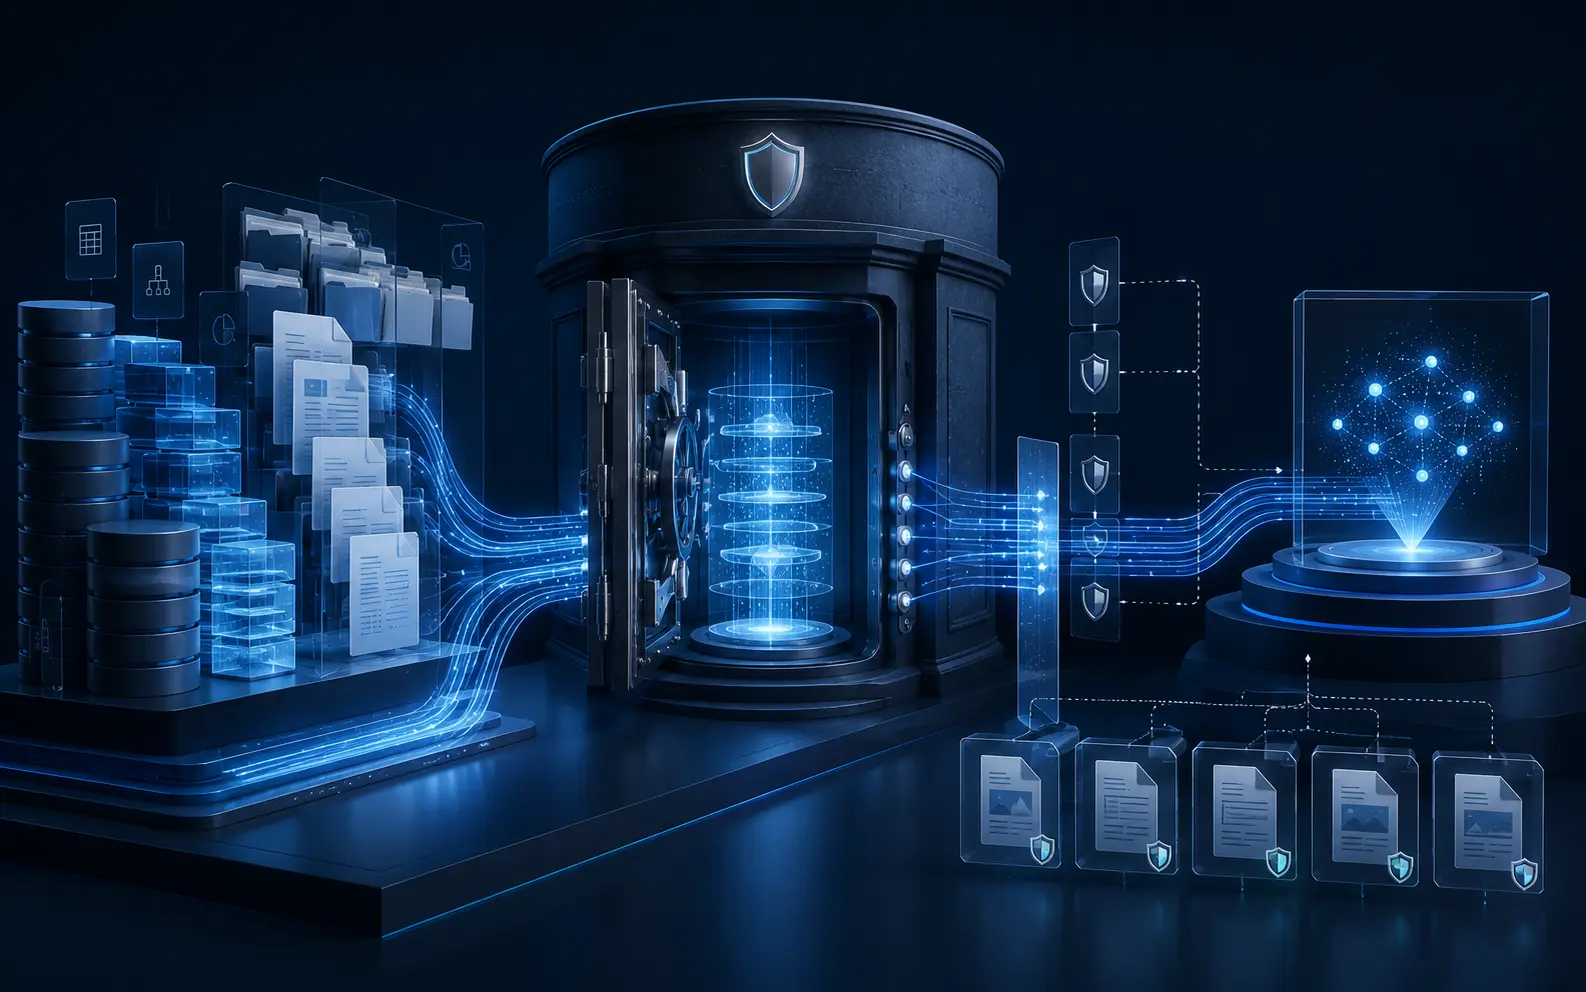
Ihr Ergebnis
Richtlinien, Handbücher, Tickets, Verträge und technische Dokumentation semantisch erschließen.
Nutzern nur Inhalte bereitstellen, für die bereits eine gültige Zugriffsberechtigung besteht.
Fundstellen anzeigen, Dokumentstände verwalten und veraltete Inhalte kontrolliert aussondern.
Antworttreue, Retrieval-Qualität, Abdeckung und Fehlantworten anhand definierter Tests bewerten.
AOIT Vorgehensmodell
Wir kombinieren Prozessverständnis, IT-Architektur, Sicherheit und Betrieb. Ein klar abgegrenzter Pilot schafft belastbare Erkenntnisse, bevor eine Lösung skaliert wird.
Wissensgrundlage
RAG verbessert Antworten nicht automatisch. Dokumentqualität, Metadaten, Zuständigkeit und Berechtigungen bestimmen, welche Informationen auffindbar sind und ob Nutzer den Ergebnissen vertrauen können. Deshalb beginnt das Projekt mit Quelleninventar und Informationsarchitektur.
DMS, SharePoint, Dateiserver, Wikis, Tickets und Datenbanken werden nach Zweck, Eigentümer, Aktualität und Schutzbedarf erfasst. Dubletten, veraltete Richtlinien und widersprüchliche Dokumentstände werden sichtbar, bevor sie in einen produktiven Suchindex gelangen.
Inhalte werden in sinnvolle Abschnitte zerlegt und mit Dokumenttyp, Version, Gültigkeit, Organisationseinheit und Quelle versehen. Tabellen, Scans und Anhänge benötigen passende Extraktion und Qualitätskontrolle, damit wesentliche Zusammenhänge beim Abruf erhalten bleiben.
Der Abruf übernimmt bestehende Benutzer- und Gruppenrechte oder bildet sie in einer kontrollierten Zugriffsschicht ab. Filter greifen vor der Übergabe an das Sprachmodell. So darf eine semantisch passende Fundstelle nicht erscheinen, wenn dem anfragenden Nutzer die Quellberechtigung fehlt.
Retrieval & Antworten
Ein RAG-System muss nicht nur sprachlich überzeugend antworten, sondern die richtigen Inhalte finden. Suchstrategie, Kontextaufbau und Antwortregeln werden deshalb gemeinsam mit Fachfragen entwickelt und gegen erwartete Quellen geprüft.
Semantische Suche, Schlüsselwörter, Metadatenfilter und gegebenenfalls ein Reranking werden kombiniert. Die passende Konfiguration hängt von Dokumentarten, Sprache, Abkürzungen und Fragestellungen ab; ein allgemeiner Vektorindex ist selten für alle Wissensbereiche optimal.
Antworten verweisen auf konkrete Dokumente und Fundstellen, damit Nutzer Aussage, Version und Kontext prüfen können. Fehlen ausreichende Belege oder widersprechen sich Quellen, soll das System Unsicherheit benennen und nicht aus allgemeinem Modellwissen eine scheinbar sichere Antwort erzeugen.
Ein fachlich gepflegter Testsatz umfasst häufige Fragen, seltene Fälle, Mehrdeutigkeiten und Fragen ohne Antwort. Gemessen werden Trefferqualität, Quellenabdeckung, Antworttreue, Berechtigungswirkung und notwendige Korrekturen – getrennt nach Wissensbereich und Nutzerrolle.
Lebenszyklus & Sicherheit
Dokumente, Rechte, Modelle und Suchverfahren ändern sich. Ein produktives RAG-System benötigt daher feste Aktualisierungs- und Kontrollprozesse sowie Schutz gegen manipulierte Quellen und unzulässige Datenabfragen.
Neue oder geänderte Dokumente werden nachvollziehbar indexiert; gelöschte Inhalte und entzogene Rechte müssen zeitnah aus dem Abruf verschwinden. Verantwortliche erhalten Berichte zu veralteten Quellen, fehlerhafter Extraktion und Indizierungsstatus.
Dokumente können versteckte Anweisungen oder gezielt falsche Informationen enthalten. Vertrauensstufen, Inhaltsprüfung, getrennte Quellbereiche und Prompt-Injection-Tests begrenzen das Risiko, dass ein abgerufener Text die Systemregeln oder Werkzeugaktionen beeinflusst.
Anfragen, Treffer, Antwortqualität und Fehler werden in angemessenem Umfang protokolliert. Datenminimierung, Aufbewahrung, Verschlüsselung, getrennte Rollen und ein abgestimmtes Modellhosting sorgen dafür, dass die Wissenssuche nicht zu einer unkontrollierten Kopie sensibler Unternehmensdaten wird.
Entscheidungshilfe für Unternehmen
Ein RAG-System passt, wenn Mitarbeitende wiederholt in freigegebenen Handbüchern, Richtlinien oder technischen Dokumenten suchen. Die Auswahl hängt von Aktualität, Berechtigungen und der gewünschten Antwortqualität ab. AOIT verbindet den Wissenszugriff mit Identitäten, Plattformbetrieb und Sicherheitsprüfung.
| Ansatz | Geeignet für | Vor der Entscheidung prüfen |
|---|---|---|
| Klassische Suche | Bekannte Begriffe und direkte Dokumentensuche | Metadaten, Filter und einheitliche Ablage |
| RAG mit Quellenbezug | Fragen über mehrere interne Dokumente | Abrufqualität, Rechte, Fundstellen und Verhalten ohne passende Quelle |
| Fine-Tuning | Spezialisiertes Verhalten oder wiederkehrende Ausgabeformate | Trainingsdaten, Evaluation und Modellpflege; ersetzt keinen aktuellen Wissensabruf |
Ein Serviceteam möchte freigegebene Anleitungen schneller finden. Für einen Pilot wird eine begrenzte Dokumentensammlung mit dokumentierten Zugriffsrechten gewählt. Ein gemeinsamer Fragenkatalog enthält richtige Antworten, veraltete Dokumentstände und Fragen ohne Fundstelle. Der Assistent soll Quellen nennen, unberechtigte Inhalte ausschließen und bei fehlender Grundlage keine vermeintlich sichere Antwort geben. Dieses Beispiel beschreibt einen möglichen Projektaufbau, keine veröffentlichte Kundenreferenz.
Bringen Sie für das Erstgespräch typische Fragen, freigegebene Beispieldokumente und Angaben zu DMS, Dateispeichern und Benutzerverwaltung mit. Vertrauliche Unterlagen werden erst über einen abgestimmten sicheren Übertragungsweg ausgetauscht.
RAG für Unternehmenswissen: Pilot besprechenHäufige Fragen
Die Antworten ordnen die wichtigsten technischen und organisatorischen Fragen ein. Der konkrete Leistungsumfang richtet sich nach Anwendung, Daten und Betriebsmodell.
RAG ergänzt ein Sprachmodell um gezielt abgerufene Inhalte aus freigegebenen Quellen. Die Anwendung sucht zunächst passende Dokumentabschnitte und übergibt sie als Kontext für die Antwort. Dadurch können unternehmensbezogene Informationen und Quellenhinweise genutzt werden, ohne das Modell mit jedem Dokument neu zu trainieren.
Nein. Gute Quellen, Suchverfahren und Antwortregeln reduzieren unbelegte Aussagen, schließen sie aber nicht vollständig aus. Deshalb gehören Quellenanzeige, Tests mit erwarteten Antworten, Unsicherheitsbehandlung und menschliche Prüfung bei kritischen Entscheidungen zum Konzept.
Berechtigungen müssen bereits beim Retrieval wirken. Der Index oder eine vorgelagerte Zugriffsschicht filtert Fundstellen nach der Identität und Rolle des Nutzers. Eine reine Anweisung im Prompt reicht nicht aus, um vertrauliche Dokumente zuverlässig zu schützen.
Geeignet ist ein fachlich klar abgegrenzter, gepflegter Bestand mit bekanntem Eigentümer und nachvollziehbaren Rechten – etwa freigegebene Handbücher oder Richtlinien. Ein begrenzter Start erleichtert Qualitätsmessung und zeigt, welche Aufbereitung für weitere Quellen erforderlich ist.